大鸟的生活实验
UAT 5/5 全过,我却不敢说「养成了」——工程完成不等于关系养成
玩伴 Asobi 跑完五轮真实验收,5/5 全过,按常规算交付成功。实验自评却更克制:工程完成,关系未完成——跨会话记忆没有自动闭环,和其它 AI 分身的差别也不够明显。用双层验收把「建好了」和「用起来了」分开,才能接着改。
读原文 ↗
12 条规则砍到 3 条——把「懂我的玩伴」编码成 Agent
上篇把「想找个玩伴」拆成四个需求:记得我、理解节奏、降低门槛、放大乐趣。这篇把它们编码成能运行的 Agent。起初规划了 12 条规则,审核时发现玩伴不是独立领域,而是通用 Agent 的扩展层——先定位,再决定写几条,最后留下 3 条。
读原文 ↗
化学学了,卤菜做了,然后呢?我用 5WHY 追「AI 玩伴」的真实需求
化学学了,卤菜做了,复盘时发现方法撑不住动力缺口。翻看自己的 AI 分身,全是任务型,没有一个会陪我玩。用三家模型并行做 5WHY,追出结论:动机的缺口不在方法层,在关系层——成年人的生活里,陪着一起探索的那个位置恰恰是空的。
读原文 ↗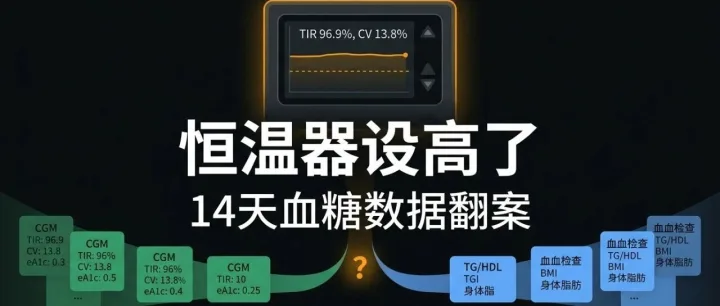
14天血糖数据翻案:我以为的代谢危机,可能只是恒温器设高了
带着「血糖有问题」的假设启动 N=1 实验,Day 1 跑偏了(产出全是数据基建),Day 2 纠偏重来。用两套独立数据交叉验证代谢风险,矛盾信号精确指向下一步最有价值的检查——答案出乎意料。
读原文 ↗
花一整天跑完4条规则,产出一堆回答不了问题的数据——AI越强,方向偏了越惨
4HH 仪表盘亮起两个风险灯,该从哪个方向开始主动干预?AI 是放大器——起点对了放大价值,起点偏了放大偏离。比「执行质量」更重要的是「方向对不对」。
读原文 ↗
靠意志力每周做健康复盘,能坚持多久?
上篇从11年 Apple Watch 数据中发现了三个隐藏模式,每条都配了行动建议。然后我盯着报告问自己:我真的会每周做一次吗?靠意志力驱动的事,长期来看几乎没有能坚持的。必须把它变成不需要意志力的系统。
读原文 ↗
把11年 Apple Watch 数据编织成叙事线,三个隐藏模式浮现了
从 Apple Health 导出11年数据:74张表、420万条记录。用上篇搭建的健康认知基础设施跑一遍真实数据,心血管、体能、睡眠三个维度的评级一目了然——但更有价值的是藏在时间线里的三个隐藏模式,体检报告永远看不到它们。
读原文 ↗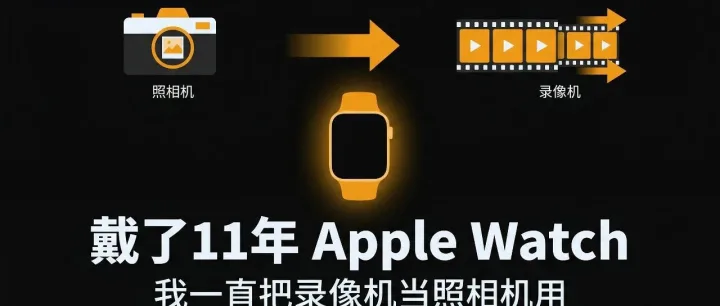
戴了11年 Apple Watch,我一直把录像机当照相机用
体检报告是一年一次的快照,Apple Watch 是11年不间断的录像机——但录像机不会自动产出洞察。用三家 LLM 做5WHY分析后发现:问题不是动机不足,而是缺少基础设施。这章记录了如何从零搭建「健康认知基础设施」:个人健康基线、证据链协议、红旗安全边界,加上一个把三者组合起来的周度复盘引擎。
读原文 ↗
怎么让OpenClaw所有智能体伙伴都能看图听话?
在 Telegram 上用 OpenClaw 管理 9 个不同角色的 bot,各司其职——但它们不会看图、不会听语音。这篇记录了从真实需求出发,一步步给所有智能体加上多模态能力的过程,包括踩过的坑和凌晨两点盯着报错发呆的那段时间。
读原文 ↗
仪表盘亮了红灯,然后呢?把焦虑变成一张行动清单
用 AI 按 Medicine 3.0 标准解读体检报告后,心血管 High、代谢 High。看完风险等级不是终点,关键是下一步怎么行动——把抽象的健康指标转化成每天可以执行的具体清单,才是真正的价值所在。
读原文 ↗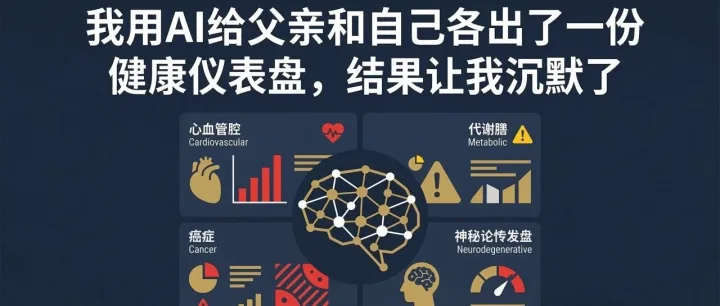
我用 AI 给父亲和自己各出了一份健康仪表盘,结果让我沉默了
用 AI 为父亲和自己生成完整健康仪表盘:解读体检指标、识别隐性风险、制定可执行改善方案。Medicine 3.0 标准下,「正常」数据里藏着的危险,肉眼看不出来。
读原文 ↗
体检报告上写着「正常」,但你可能已经危险了
用 AI 重新解读父亲的体检报告,发现传统「正常」标准掩盖了心血管高风险。Medicine 3.0 的长寿标准比传统体检严格 2-6 倍,空腹胰岛素「正常」时胰岛素抵抗可能已存在十年。
读原文 ↗